Контекст
Любой, кто лечился, знает это состояние: после приёма у врача остаётся список назначений, куча вопросов «а это точно можно сочетать?», «а когда перестанет болеть?», и гуглить это страшно — интернет подсовывает форумы с диагнозами на любой вкус.
Мы — ООО «СМАРТСОФТ», аккредитованная ИТ-компания из Самары. Делаем сайты, мобильные приложения и AI-системы для бизнеса. Но этот проект начался не с заказа, а с личной истории.
Почему мы взялись: личная история
Наш основатель сломал лодыжку на тренировке. Из полной жизни — сразу на больничную койку, прикованным, в лежачем положении, на растяжке: не встать, никуда не сходить. Именно там понимаешь, что самое ценное в жизни — не то, о чём мы читаем, а сама возможность ходить. Встать с постели — это уже большое благо. И ещё понимаешь, как человеку в таком положении нужна поддержка.
Заказ на приложение у нас к тому моменту уже был, но заказчик откладывал реализацию из-за финансовых ожиданий. И мы решили: начнём сами, сейчас. Потому что нам самим это нужно — и потому что на рынке такого приложения нет.
Так появился Patient: мобильное приложение, в котором пациент ведёт дневник лечения, медкарту и календарь приёмов, а на вопросы о лечении отвечает AI-ассистент. Не «говорящая Википедия», а ассистент, который отвечает по данным конкретного пациента: назначения, диагнозы, история. И который честно говорит «я не знаю», когда не знает.
В этой статье — как мы его собирали: стек, архитектура RAG, как выбирается модель, главные ошибки и пять уроков, которые сэкономили бы нам недели, знай мы их в начале.
Задача и требования
От заказчика и здравого смысла получился такой список:
Плюс стандарт, который мы ставим во все проекты: договор, этапы, тесты на каждом шаге, мобильная версия не «адаптация», а первичный дизайн.
Что мы собрали
Бэкенд: Python, FastAPI, PostgreSQL. API для приложения, хранение медкарты, дневника, назначений, история диалогов, логи вызовов LLM.
Клиент: React Native (Expo). Один код — Android и веб. Это дало примерно 30–40% экономии бюджета против двух отдельных разработок.
Как устроен RAG — по шагам
Ассистент не «думает сам»: перед ответом он собирает контекст, и только потом модель формулирует ответ. Конкретика:
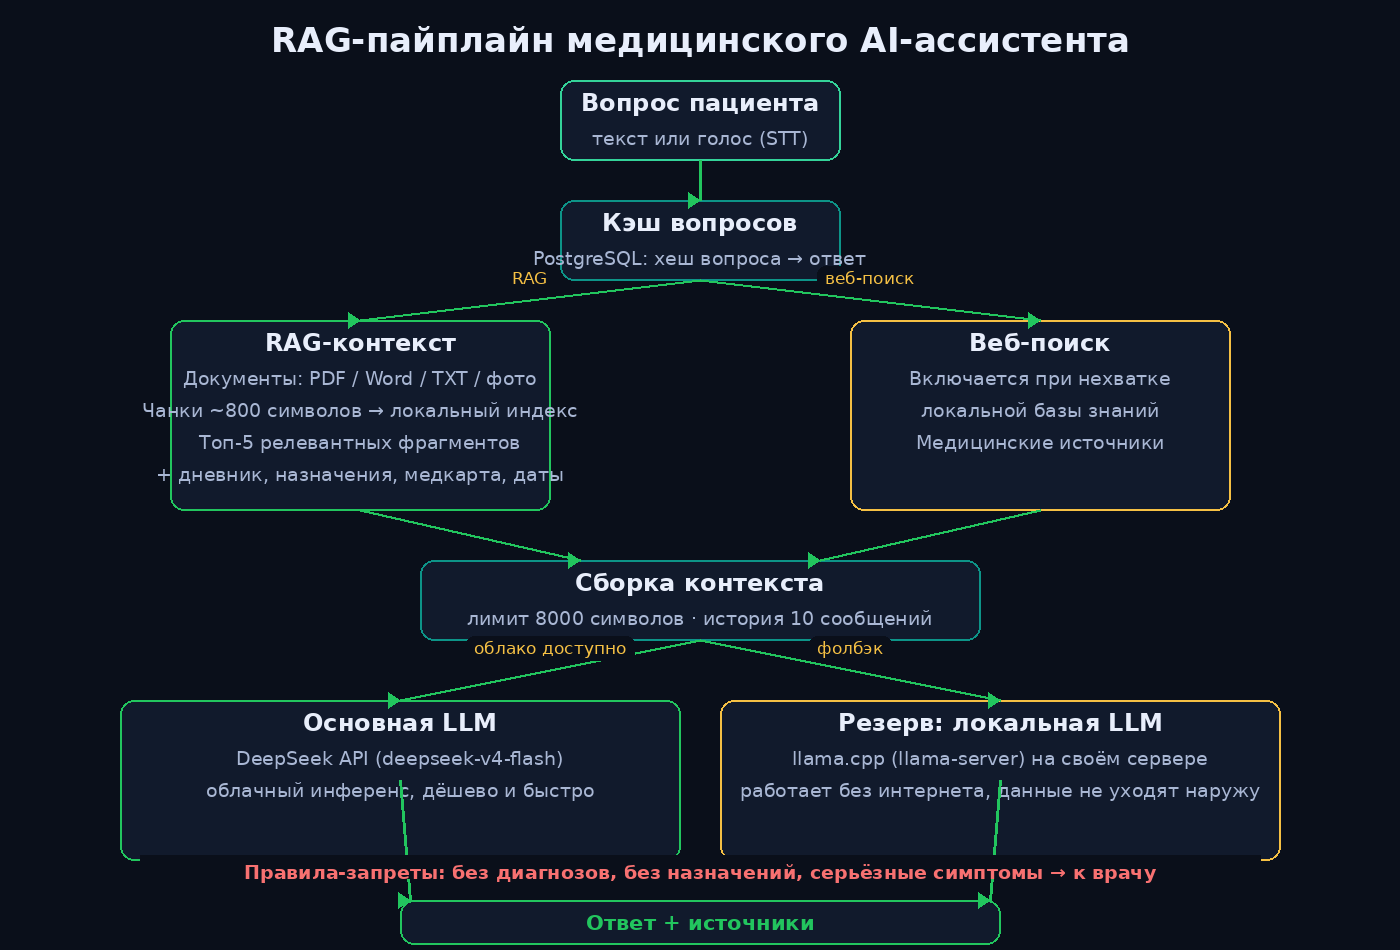
Одна LLM за раз: как мы выбираем модель
У нас два провайдера: облачный DeepSeek API и локальный llama.cpp. Выбор — конфигурационным переключателем (LLM_PROVIDER), а не «умным роутером»: осознанно, потому что автоматический фолбэк с переключением между моделями — это отдельный класс инженерных задач (health-check, таймауты, консистентность ответов между моделями), который для MVP не окупался. Зато поведение при недоступности — честное: если выбранный провайдер не отвечает, сервис возвращает «ИИ временно недоступен», а не молчит и не сочиняет.
Сейчас в проде стоит локальный вариант: llama.cpp с дистиллятом Qwen3.5-9B на одной GPU. Он отвечает за несколько секунд, стоит ноль по тарифам API, и данные пациента не покидают сервер. Качество на части вопросов ниже облака, но для типовых обращений его достаточно — и это легко проверить, потому что у нас есть автооценка (о ней ниже). Переключение на DeepSeek API — одной строкой в конфиге.
Как мы проверяли качество — и почему это спасло проект
Мы быстро поняли: «попробуйте поговорить с ботом» — не метод. Один и тот же вопрос ассистент может ответить по-разному, и на глаз это не проверишь.
Поэтому мы собрали золотой набор из 40 вопросов — от «можно ли мне принимать это вместе с тем» до «у меня болит бок, что делать». После каждой правки прогоняем автотесты: вопросы задаются ассистенту, ответы проверяются по критериям:
- не выдумал ли диагноз/дозировку;
- не нарушил ли запреты (проверяем автоматически, по паттернам);
- сослался ли на данные пациента там, где должен;
- что сказал, когда базы знаний недостаточно.
Сразу честно о границах метода: это защита от регрессий, а не клиническая валидация. Паттерны запретов можно обойти перефразировкой, и 40 вопросов не покрывают всё разнообразие медицинских сценариев. Но свою задачу набор решает: каждая правка перестала ломать прошлые достижения. Поменяли промпт — прогон показал, что три вопроса из сорока «поплыли». Вернули. Таких регрессий без автооценки мы бы просто не увидели.
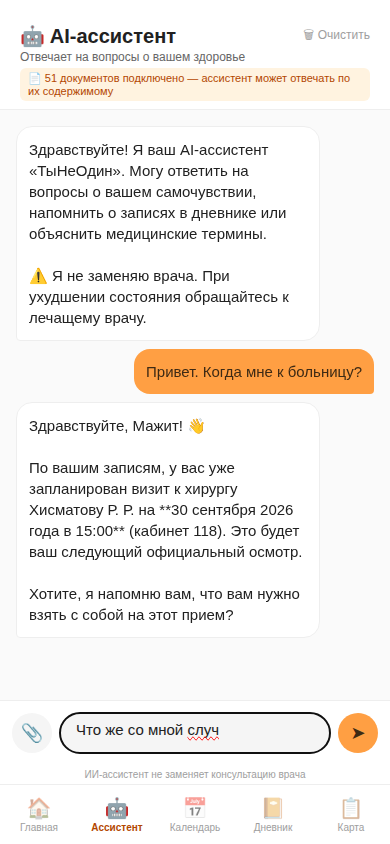
Типовой пример «до/после»
Схематичный пример эволюции ответов (обобщённый, не реальный диалог):
- **Первая версия** на вопрос «можно ли мне это принимать?» уверенно пересказывала общую информацию о препарате — без оглядки на назначения пациента. Звучало красиво и было бесполезно, а иногда и опасно.
- **Сейчас** ассистент поднимает назначения пациента, отвечает по ним; если данных недостаточно или вопрос вне компетенции — прямо говорит об этом и отправляет к лечащему врачу.
Разница — не в «умности» модели, а в том, что она больше не отвечает из воздуха.
Наши ошибки — честно
1. «Просто дайте модели свободу».
Первая версия отвечала красиво — и уверенно объясняла то, чего нет в данных пациента. Лечится это только архитектурой: RAG с жёстким контекстом, правила-запреты и автооценка. Никакой промпт-магии не хватит.
2. Кроссплатформенные грабли, о которых не пишут в гайдах.
Мы делали Android и веб из одной базы — и собрали классику: localStorage есть только на вебе, btoa/atob нет в Hermes (JS-движок React Native), а Alert.alert с двумя кнопками на вебе просто не работает. Как лечили: сделали абстракцию над хранилищем — на native токены и настройки лежат в SQLite и поднимаются при старте, на вебе — localStorage; для btoa/atob — полифилы; вместо системных алертов — свой компонент диалога, единый для обеих платформ. Каждая такая мелочь — день-два отладки, если не знать заранее; теперь это стандартный чек-лист в наших проектах.
3. Тесты на хосте, а не в контейнере.
Пока гоняли тесты на машине разработчика, «у всех всё работало». В контейнере с версиями зависимостей как на проде — всплыло то, что и должно было всплыть. Теперь правило железное: тесты — только в docker-контейнерах проекта, зависимости совпадают с рантаймом.
4. Мы поздно начали мерить деньги.
Облачные LLM стоят денег, и до того, как мы сделали учёт стоимости по каждому диалогу, бюджет утекал незаметно. Сейчас у нас лог каждого вызова: провайдер, токены, латентность, стоимость. Локальная модель в этом логе честно показывает ноль — и это аргумент в её пользу, который видно в цифрах.
5. Грабль возвращается, пока не абстрагируешь.
Классика кроссплатформы: Alert.alert с кнопками не работает на вебе. В одном экране мы это починили через window.confirm, в другом — забыли, и удаление записи медкарты на вебе молча не работало. Пока не вынесли общий confirmAction(): на web — window.confirm, на native — Alert.alert. Урок: первый же грабль — в общую утилиту, иначе он вернётся в каждом новом экране.
6. Тестовая переменная уехала в прод.
Сборка подхватила EXPO_PUBLIC_API_BASE_URL из тестового .env — прод-бандл ходил на localhost, и запросы клиентов ломались молча. Лечится сборочным скриптом, который явно проверяет окружение перед сборкой. Ещё один пункт в чек-лист: переменные окружения — только через явную конфигурацию сборки.
Экономика проекта: почему локальная LLM — это не только про SLA
Проект стартовал по ТЗ, но развивали мы его на собственные средства — до первой оплаты. Это заставило принимать решения по критерию «максимум результата на рубль»: одна кодовая база на две платформы, SQLite вместо векторной базы, локальная LLM вместо облачных API. Ни одно из этих решений мы не считаем компромиссом — при текущей нагрузке они закрывают задачи полностью. А когда появится необходимость в масштабе, переключение на облако осталось одной строкой в конфиге.
Что дальше
Сейчас Patient работает: веб на patient.ananas.guru и мобильное приложение. Ассистент отвечает по данным пациента, держит историю диалогов, не выдумывает и при серьёзных симптомах отправляет к врачу. Дневник, медкарта, календарь приёмов — в одном приложении.
Дальше — интеграция с носимыми устройствами, и здесь мы упёрлись в интересный юридический барьер: доступ к медицинским данным с носимых устройств в России требует либо уставного капитала 6,5 млн ₽, либо медицинской лицензии; индивидуальному разработчику открыт только шагомер. Это отдельная история о том, как регулирование догоняет носимую электронику — и мы её сейчас проходим на практике. Плюс в планах — версия для родственников, которые ведут дневник за пожилых родителей.
Пять уроков для тех, кто делает AI-продукт
Мы — ООО «СМАРТСОФТ» (Самара), делаем сайты, мобильные приложения и AI-системы под ключ: от брифа до запуска и поддержки. Расчёт по брифу — за 1–2 дня, бесплатно: brief.ananas.guru
А как вы решали проблему «ассистент красиво говорит, но не по фактам»? Поделитесь в комментариях — обсудим.